
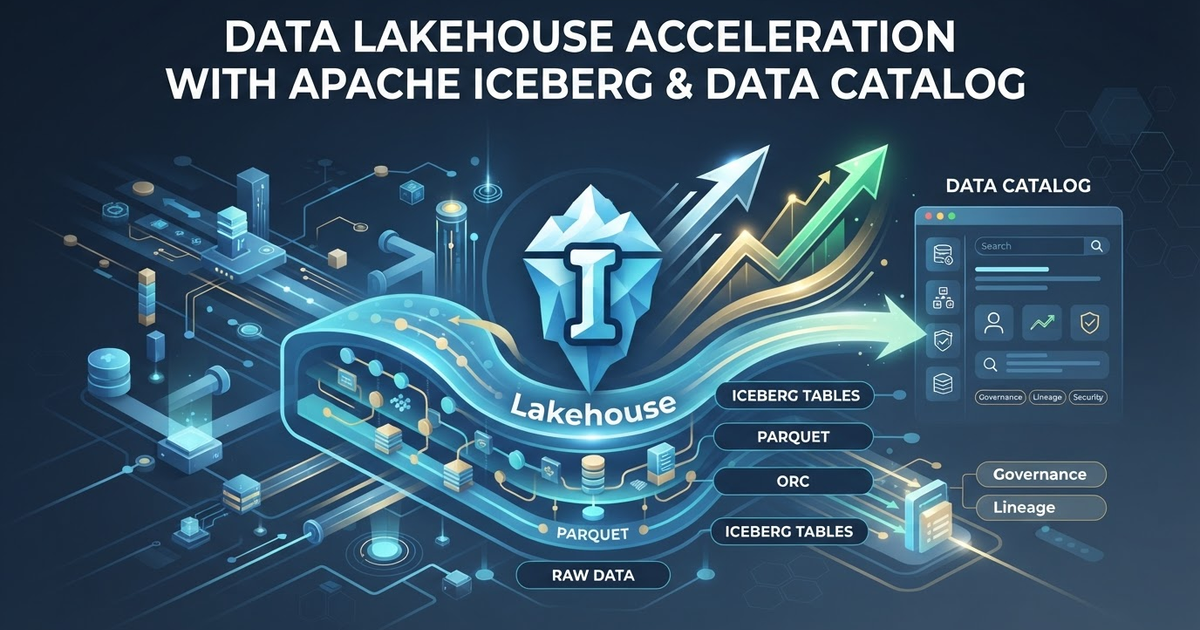
À medida que as empresas avançam na modernização de suas arquiteturas de dados, a adoção de formatos abertos como o Apache Iceberg tem se tornado um padrão. Essa abordagem permite a criação de um repositório de dados unificado e acessível por múltiplos motores de processamento compatíveis, abrindo caminho para data lakehouses nativas de IA, capazes de transformar dados brutos em conhecimento semântico, impulsionar ações proativas e operar em escala agentic.
Um componente fundamental de qualquer data lakehouse é o catálogo, e no ecossistema Apache Iceberg, essa função é tipicamente desempenhada pelo Iceberg REST Catalog. Este catálogo é responsável por gerenciar os ponteiros de tabelas, orquestrar commits atômicos e servir como a única fonte de verdade para a localização dos dados. Contudo, com a crescente complexidade e escala das organizações que adotam a arquitetura lakehouse, a necessidade de um catálogo gerenciado, altamente escalável e disponível, se tornou evidente. Essa demanda se intensifica ainda mais à medida que a consulta de dados se expande, especialmente com o uso de agentes.
Para suportar um volume massivo de consultas pequenas e repetitivas, especialmente por agentes de software, é crucial construir sobre uma base de catálogo gerenciado que garanta atomicidade, consistência, disponibilidade e concorrência em larga escala. Neste artigo, exploraremos os desafios inerentes a um catálogo gerenciado em ambientes de nuvem modernos e em escala agentic. Apresentaremos como o Lakehouse runtime catalog do Google Cloud, uma solução serverless, pode ser a resposta.
Alimentado pelo Spanner, o banco de dados sempre ativo do Google Cloud com escalabilidade virtualmente ilimitada, e construído para atender à especificação aberta do Iceberg REST Catalog, o Lakehouse runtime catalog oferece a fundação robusta, escalável e disponível necessária para a era agentic.
Desafios de um Catálogo Gerenciado na Arquitetura Lakehouse
Ao dialogar com engenheiros de dados e líderes de infraestrutura que gerenciam cargas de trabalho analíticas em produção e em larga escala dentro de um Lakehouse, alguns pontos de dor recorrentes emergem:
- Commits Atômicos e Controle de Concorrência: O Apache Iceberg garante transações ACID por meio de controle de concorrência otimista (OCC). Um catálogo gerenciado deve implementar uma operação robusta de compare-and-swap (CAS) para garantir a troca atômica do ponteiro de metadados.
- Alta Disponibilidade e Manutenção Operacional: Falhas de consulta são imediatas caso o catálogo esteja indisponível, o que classifica um catálogo gerenciado como um serviço crítico de Nível 1.
- Escalabilidade do Banco de Dados Subjacente: Arquitetos de catálogo frequentemente se deparam com um dilema ao escolher o banco de dados para armazenar metadados e o estado das tabelas. Bancos de dados relacionais tradicionais que escalam verticalmente oferecem SQL e transações ACID, mas atingem limites de CPU, memória, armazenamento e conexões sob cargas de leitura/escrita concorrentes pesadas. A sharding manual para contornar isso gera um overhead operacional imenso. Por outro lado, sistemas de banco de dados que escalam horizontalmente podem apresentar consistência eventual, serem difíceis de gerenciar ou simplesmente não estarem prontos para o ambiente corporativo.
- Coordenação de Manutenção de Tabelas: Um catálogo, por si só, não otimiza os dados. É necessário construir e operar pipelines auxiliares para compactação, expiração de snapshots, reescrita de manifestos e limpeza de arquivos órfãos.
- Governança e Segurança: O catálogo atua como um porteiro de segurança. Ele deve implementar e manter:
- Protocolos de autenticação (ex: troca de tokens OAuth2, federação IAM).
- Controle de acesso granular, desde o nível de namespace até o nível de tabela.
- Credenciais de armazenamento fornecidas (ex: geração de tokens de curta duração para evitar que os motores de consulta necessitem de credenciais de armazenamento amplas e diretas).

Lakehouse Runtime Catalog: A Solução do Google Cloud
Para endereçar esses desafios, o Google Cloud lançou o Lakehouse runtime catalog (GA), com suporte para Iceberg Rest Catalog. Esta solução é um registro de metadados unificado, totalmente serverless, altamente disponível e projetado desde o início para dar suporte a formatos de tabela abertos modernos como o Apache Iceberg.
Ao implementar nativamente a especificação Apache Iceberg REST Catalog, o Lakehouse runtime catalog desacopla a descoberta de metadados dos motores de computação. Isso garante que múltiplos motores compatíveis com Iceberg possam acessar um repositório de dados compartilhado, permitindo que as organizações levem suas cargas de trabalho para produção mais rapidamente. Experiências de sucesso, como a migração do catálogo da Etsy para o Lakehouse runtime catalog, que acelerou consultas de pipeline em 60% ao unir dados no local, demonstram o valor desta abordagem.
Benefícios Arquiteturais do Lakehouse Runtime Catalog:
- APIs Abertas: O suporte ao Iceberg Rest Catalog permite que diferentes equipes utilizem suas ferramentas de análise preferidas sobre um único conjunto de dados unificado.
- Interoperabilidade Multi-Engine: Uma vez registradas, as tabelas se tornam imediatamente descobertas e consultáveis através do Google Cloud Managed Service for Apache Spark, BigQuery e motores open-source, utilizando interfaces REST padrão.
- Interoperabilidade de Leitura/Escrita para Tabelas Iceberg: Utilize motores compatíveis com Iceberg, como BigQuery e Managed Spark, para escrever em tabelas Iceberg registradas no Lakehouse runtime catalog. Clientes também podem usar o Managed Spark para escrever em tabelas Iceberg em catálogos externos.
- Armazenamento Iceberg Totalmente Gerenciado com Recursos de Nível Empresarial: Aproveite a infraestrutura diferenciada do Google para executar análises de alto desempenho em tabelas Iceberg. Isso combina a flexibilidade do open-source com performance, escalabilidade, governança e processamento multimodal.
- Zero Cópia de Dados: As definições de tabela apontam diretamente para os dados existentes no object store subjacente, eliminando a necessidade de mover, reescrever ou duplicar os dados.
- Federação de Catálogo Bidirecional entre Nuvens: Acesse dados de diversas fontes, incluindo conexões cross-cloud com Databricks e outros provedores, unificando a gestão de metadados.
Em suma, o Lakehouse runtime catalog, com o suporte do Spanner, emerge como uma solução poderosa para os desafios de gerenciamento de metadados em arquiteturas lakehouse modernas, capacitando as empresas a alavancar o potencial dos dados abertos com escalabilidade, confiabilidade e eficiência.




chat_bubble Comentários (0)
Nenhum comentário ainda. Seja o primeiro a comentar!
Deixe seu comentário