
BigQuery Amplia Capacidades com Tabelas Iceberg e Modelo Gemini 2 em General Availability
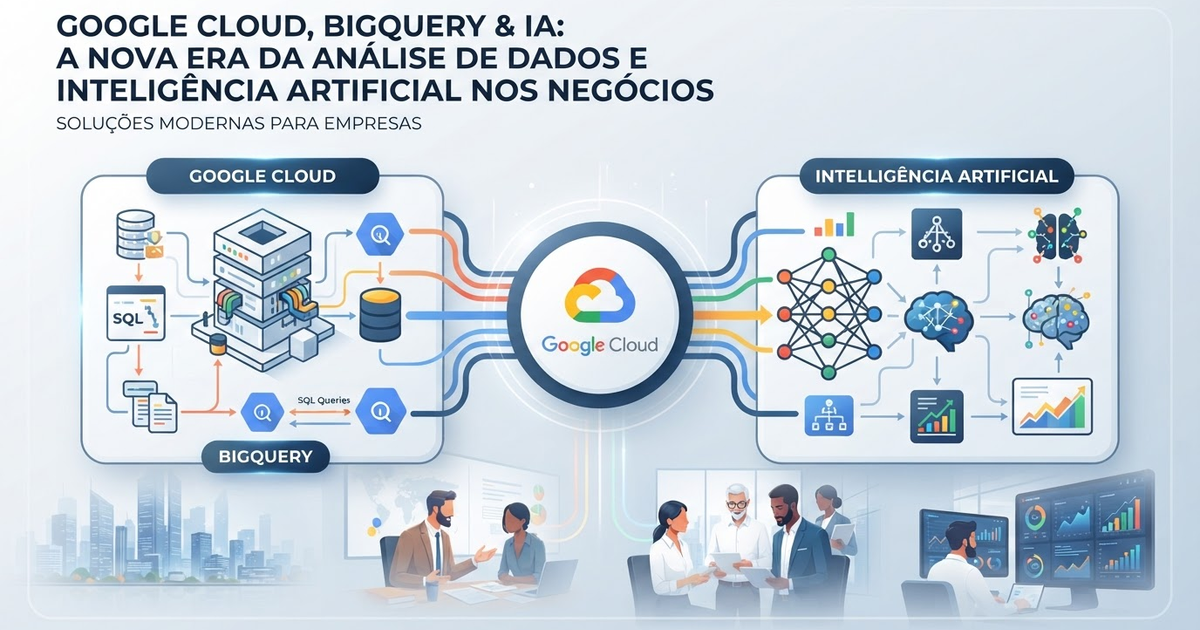
O Google Cloud anunciou avanços significativos em sua plataforma de dados, o BigQuery, com a disponibilidade geral (GA) de funcionalidades cruciais para análise e inteligência artificial. A partir de agora, as tabelas externas e gerenciadas no formato Iceberg no BigQuery suportam nomes de colunas flexíveis por padrão, simplificando o manuseio de dados.
Tabelas Iceberg com Flexibilidade de Nomes em GA
A adoção de tabelas Iceberg no BigQuery agora se torna mais robusta e intuitiva. Com o suporte a Iceberg external tables e Iceberg managed tables agora em General Availability (GA), os usuários se beneficiam da flexibilidade em nomes de colunas. Essa melhoria visa otimizar a experiência de desenvolvimento e a escalabilidade na gestão de grandes volumes de dados, especialmente em cenários que envolvem fontes de dados heterogêneas.
Gemini 2: Poder de Embedding para Dados Multimodais e Longos
Em paralelo, o modelo de inteligência artificial gemini-embedding-2 também alcançou o status de General Availability. Este modelo se destaca pela sua capacidade de gerar embeddings de alta qualidade para strings longas, incluindo dados multilingues e não estruturados. Sua versatilidade é ampliada pelo suporte a uma gama variada de tipos de arquivos, como texto, imagens, áudio, vídeo e PDFs.
Desenvolvedores e analistas podem integrar o modelo gemini-embedding-2 em fluxos de trabalho de IA através das funções AI.EMBED, AI.SIMILARITY e AI.GENERATE_EMBEDDING dentro do BigQuery ML. Essa capacidade é fundamental para aplicações que exigem compreensão semântica avançada, busca por similaridade e análise de conteúdo multimodal.
Impacto no Mercado e Negócios
A disponibilização geral dessas funcionalidades representa um passo importante para empresas que buscam extrair o máximo valor de seus dados. A flexibilidade nas tabelas Iceberg facilita a integração com ecossistemas de dados abertos, enquanto o modelo Gemini 2 abre portas para inovações em análise de conteúdo, personalização e sistemas de recomendação.


💡 Opinião do Editor
A notícia sobre a General Availability (GA) das tabelas Iceberg no BigQuery, com a flexibilidade de nomes de colunas que finalmente chega para abraçar a realidade de muitas equipes de dados, é um sopro de ar fresco. Ao longo de duas décadas no mundo dos dados, vi a frustração que nomes de colunas inconsistentes ou mal definidos podem gerar em projetos, e a burocracia que muitas vezes acompanha a tentativa de corrigi-los. Essa evolução do BigQuery, sem a necessidade de migrações complexas, é um avanço prático monumental. E, como se não bastasse, a integração do Gemini 2 para embeddings eleva o patamar da análise de dados para um novo nível de inteligência artificial. Para vocês, que lidam com a complexidade do dia a dia, minha recomendação é clara: mergulhem nessas novas funcionalidades agora. Testem as tabelas Iceberg em seus workloads atuais, avaliem como a flexibilidade de nomes de colunas pode simplificar seus pipelines e explorem o potencial do Gemini 2 para extrair insights mais profundos de seus dados. Não esperem a "hora perfeita"; a hora de otimizar suas operações de dados e impulsionar a inovação é agora.
chat_bubble Comentários (0)
Nenhum comentário ainda. Seja o primeiro a comentar!
Deixe seu comentário