
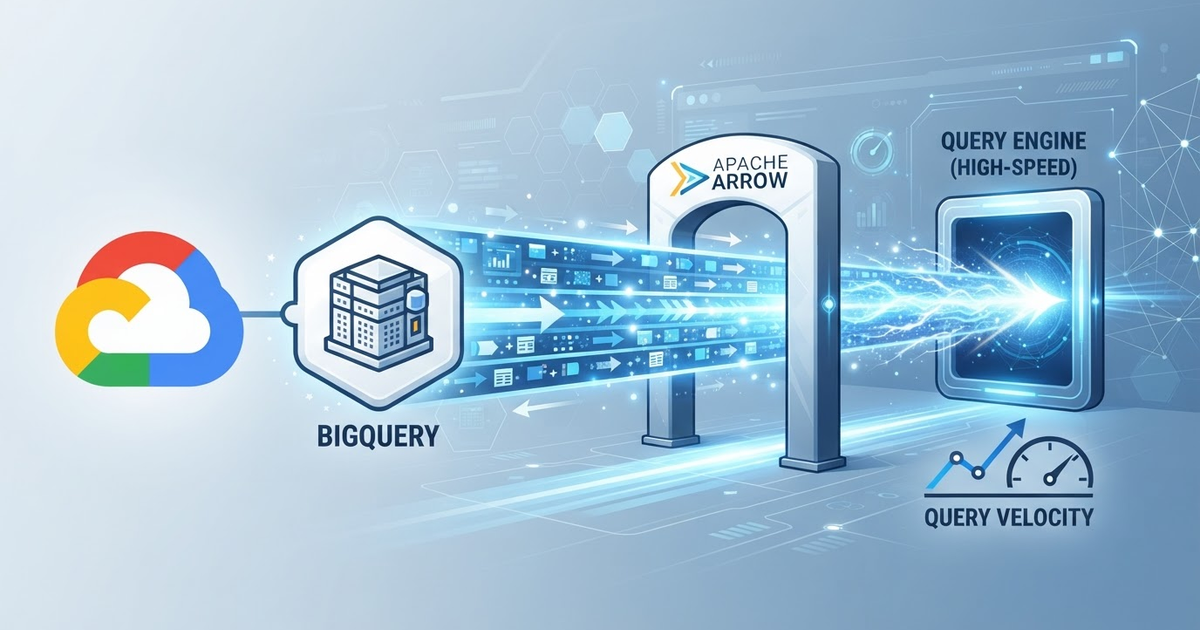
BigQuery Introduz Suporte ao Apache Arrow para Consultas Mais Rápidas
Em um movimento que visa otimizar a performance para seus usuários, o Google Cloud BigQuery anunciou uma nova funcionalidade que permite a recuperação de resultados de consultas diretamente no formato Apache Arrow. Esta novidade, que se encontra em fase de Preview, promete agilizar significativamente o processo de obtenção de dados e aprimorar a eficiência da serialização.
A adoção do Apache Arrow como formato de saída para consultas no BigQuery representa um avanço importante para empresas que lidam com grandes volumes de dados e que necessitam de acesso rápido e eficiente para suas análises e aplicações. O formato Apache Arrow é amplamente reconhecido em ecossistemas de Big Data por sua capacidade de oferecer operações de dados mais rápidas e com menor sobrecarga, facilitando a interoperabilidade entre diferentes ferramentas e sistemas.
Para negócios que buscam extrair insights de forma ágil, a capacidade de recuperar dados mais rapidamente pode se traduzir em tomadas de decisão mais assertivas e em um ciclo de análise mais curto. A melhoria na eficiência de serialização também contribui para a redução de custos de processamento e transferência de dados, tornando a plataforma ainda mais competitiva no mercado de nuvem.
Embora a funcionalidade esteja em fase de Preview, a sua introdução sinaliza o compromisso do Google Cloud em aprimorar continuamente o BigQuery, um de seus pilares para análise de dados em larga escala. Usuários interessados em experimentar esta nova capacidade devem consultar a documentação oficial para detalhes sobre como habilitá-la em seus projetos.
Fonte: BigQuery Revision History

💡 Opinião do Editor
Essa notícia sobre o BigQuery suportar Apache Arrow na saída de consultas me anima bastante, e não é para menos! Depois de tantos anos lidando com o fluxo de dados e buscando otimizar a performance em projetos complexos, vejo nessa integração um ganho real e palpável. O Arrow, com sua arquitetura de memória colunar e otimização para transferência, é um divisor de águas quando o assunto é minimizar gargalos de I/O e latência. Para nós, que trabalhamos no dia a dia gerindo times e entregando soluções baseadas em dados, significa menos tempo de espera para os analistas e cientistas obterem os resultados, o que se traduz diretamente em ciclos de desenvolvimento mais rápidos e maior agilidade para o negócio. A eficiência na serialização também é um ponto crucial, especialmente em cenários onde os dados precisam ser movidos rapidamente entre sistemas ou para ferramentas de visualização. Minha recomendação é clara: se você está usando BigQuery e ainda não explorou essa funcionalidade em preview, comece a testar agora. Avalie como essa mudança pode impactar suas aplicações e fluxos de trabalho de ingestão e processamento, pois o potencial de aceleração é imenso e pode ser o diferencial que você precisa para escalar suas operações de dados.
chat_bubble Comentários (0)
Nenhum comentário ainda. Seja o primeiro a comentar!
Deixe seu comentário