
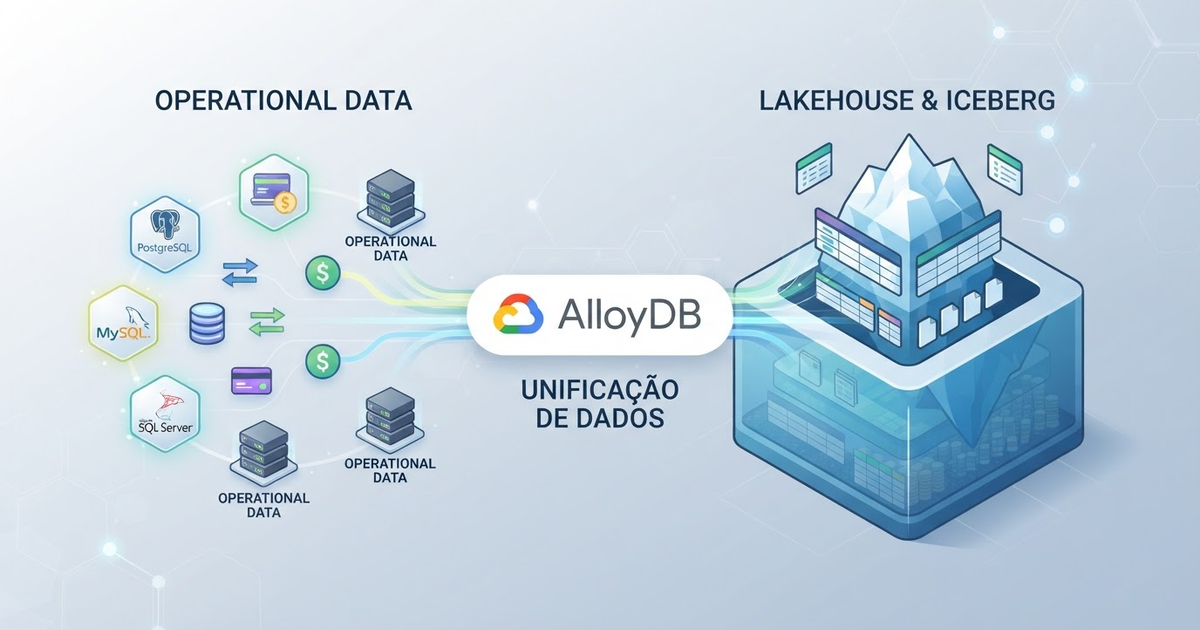
AlloyDB para PostgreSQL Amplia Capacidades com Integração Direta ao Iceberg
Para a tomada de decisões de negócio eficazes, a integração de dados é fundamental. Historicamente, dados operacionais em tempo real e o contexto histórico armazenado em sistemas analíticos, como data warehouses ou lakehouses, eram mantidos em silos. Essa realidade está mudando rapidamente com a evolução das tecnologias de gerenciamento de dados.
Neste cenário, o Google Cloud anuncia a funcionalidade de acesso direto ao Apache Iceberg no AlloyDB for PostgreSQL, agora em preview. Essa inovação permite que desenvolvedores consultem tabelas Iceberg armazenadas em buckets de armazenamento em nuvem diretamente do AlloyDB. A grande vantagem é a capacidade de unir esses dados históricos com informações operacionais ao vivo em uma única consulta SQL.
Três Vias para Interagir com o Lakehouse no AlloyDB
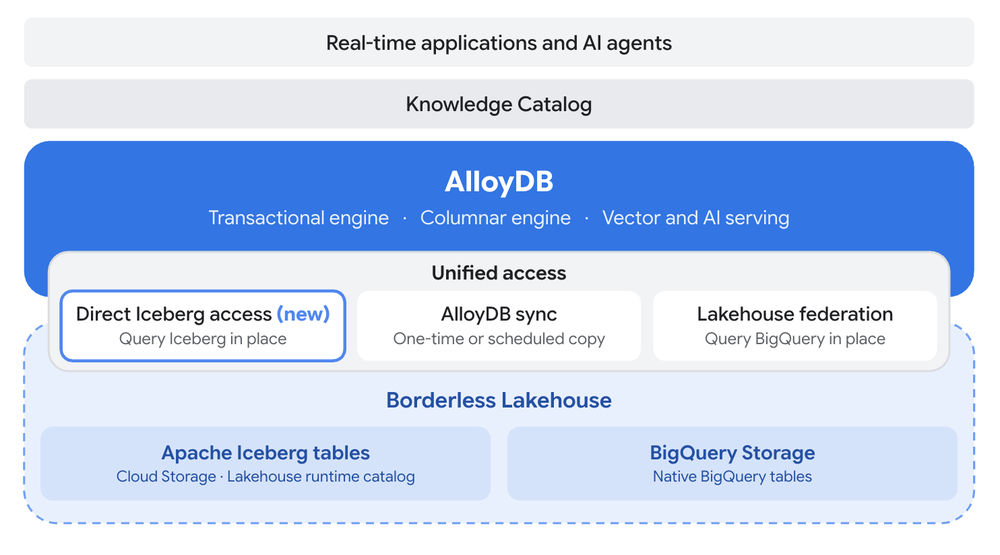
Complementando o acesso direto ao Iceberg, o Google Cloud também anuncia a disponibilidade geral (GA) do AlloyDB sync e da Lakehouse federation. Essas funcionalidades, em conjunto, oferecem ao AlloyDB três abordagens distintas para trabalhar com o conceito de Lakehouse sem fronteiras, mantendo uma cópia aberta dos dados acessível por múltiplos motores de análise.
A experiência da Etsy ilustra o poder dessa unificação: a empresa integrou três petabytes de dados, acelerando consultas de pipeline em 60% ao processar dados em seu local original. A escolha da abordagem mais adequada com o AlloyDB dependerá da localização dos dados e de como as aplicações os consomem:
- Acesso Direto ao Iceberg (Preview): Permite a leitura de tabelas Iceberg diretamente onde residem, otimizadas pelo motor colunar do AlloyDB.
- AlloyDB Sync (GA): Ideal para cargas de trabalho que exigem latência mínima, servindo dados do Lakehouse a partir do AlloyDB, com atualizações programadas.
- Lakehouse Federation (GA): Possibilita a consulta de tabelas nativas do BigQuery in loco, com o BigQuery gerenciando o processamento.
Com essas novidades, aplicações e agentes inteligentes podem operar sobre dados operacionais e do Lakehouse de forma unificada, eliminando a necessidade de construir e gerenciar pipelines de dados customizados.
Decisões no Momento da Ação
A integração entre o AlloyDB e o Lakehouse permite que o contexto histórico de dados esteja acessível lado a lado com transações em tempo real. Isso possibilita a tomada de decisões cruciais no exato momento da interação do usuário ou da ocorrência de um evento, sem a complexidade de pipelines de dados tradicionais.
Exemplos práticos incluem:
- Prevenção de Fraudes e Gestão de Riscos: Agentes de fraude podem analisar o histórico de transações de um cliente por cinco anos (no Iceberg) e os últimos 30 dias (no banco de dados) antes de aprovar um pagamento.
- Personalização de Experiências: Agentes de compra podem cruzar o carrinho de compras em tempo real com o valor vitalício e o histórico de devoluções do cliente (no Lakehouse) para oferecer a promoção ideal enquanto ele navega.
- Precificação Dinâmica: Agentes de precificação podem combinar o inventário atual (no AlloyDB) com anos de dados históricos de demanda e clima (no Lakehouse) para ajustar preços em tempo real conforme as condições mudam.
- Produtos de Dados: Equipes de dados podem curar e publicar tabelas uma única vez no Iceberg, permitindo que múltiplas aplicações consumam esses dados em seu local de origem, em vez de manter cópias independentes.
Nestes cenários, o histórico dos dados permanece no Lakehouse, e a decisão é tomada no banco de dados. Os agentes executam ações em nome do usuário, com base nas permissões concedidas no AlloyDB.
Acesso Direto ao Iceberg no AlloyDB (Preview)
Com o acesso direto ao Iceberg, o AlloyDB lê tabelas Apache Iceberg diretamente do Cloud Storage, seja por meio de um caminho de bucket ou do catálogo de tempo de execução do Lakehouse. Após o registro de uma tabela Iceberg, ela pode ser consultada como qualquer tabela PostgreSQL nativa, inclusive em junções com tabelas operacionais ao vivo.
O suporte ao Iceberg é nativo no AlloyDB e acelerado pelo AlloyDB columnar engine, garantindo alta performance em consultas sobre dados do Lakehouse. Essas consultas rodam na mesma instância do banco de dados da aplicação, eliminando a necessidade de instâncias de leitura separadas e acessando os dados mais recentes publicados no Lakehouse.
Em testes com um dataset de 1 TB no Cloud Storage, o acesso direto ao Iceberg no AlloyDB demonstrou ser significativamente mais rápido: até 7x mais rápido em consultas de agregação comparado a um serviço PostgreSQL compatível da Amazon, e até 3.5x mais rápido que a extensão PostgreSQL open-source.
AlloyDB Sync para Leituras de Baixíssima Latência (GA)
Nem todos os dados do Lakehouse precisam ser acessados in loco. Para informações como um score de risco de crédito de cliente, que é consultado a cada transação mas recalculado apenas periodicamente, mantê-lo como uma tabela local no AlloyDB oferece a leitura mais rápida. A inovação do AlloyDB Sync reside em simplificar a manutenção dessa cópia atualizada, sem a complexidade de pipelines customizados.
O AlloyDB sync copia dados do Lakehouse (originados no BigQuery) para o AlloyDB, permitindo execuções únicas ou programadas para manter os dados atualizados. Essa cópia local no AlloyDB garante que sua aplicação acesse esses dados com a mesma velocidade de qualquer outra tabela nativa, podendo ser indexada e servida de forma eficiente.


chat_bubble Comentários (0)
Nenhum comentário ainda. Seja o primeiro a comentar!
Deixe seu comentário