
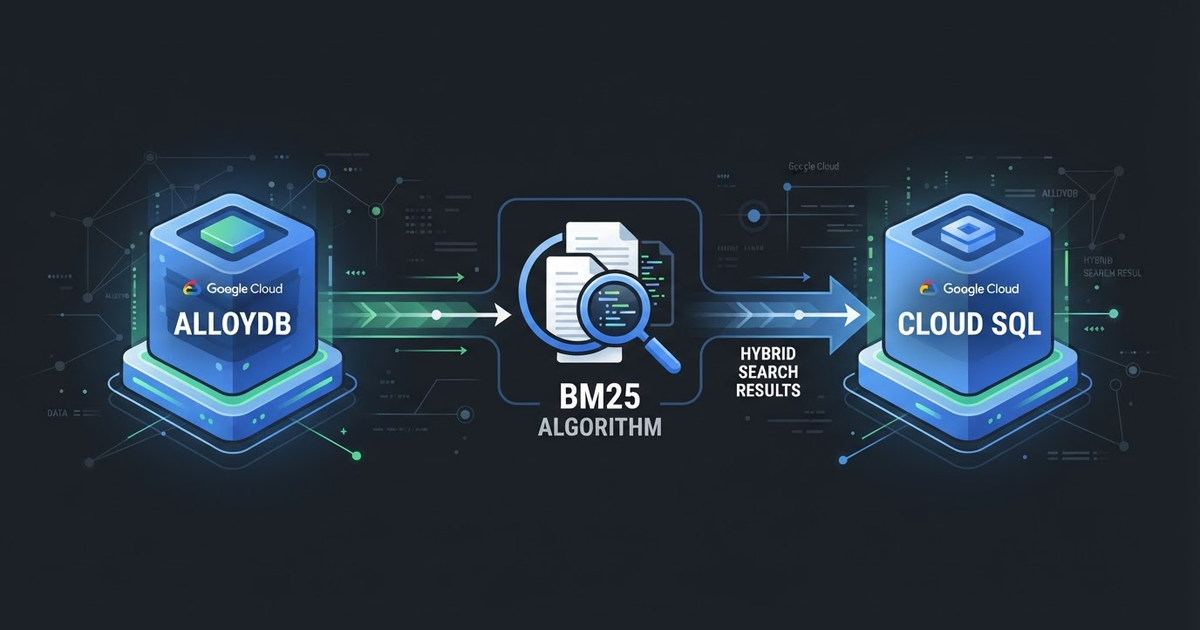
AlloyDB e Cloud SQL Ganham Busca Híbrida Nativa com BM25
No universo em constante evolução da inteligência artificial generativa, arquiteturas RAG (Retrieval-Augmented Generation) e agentes de dados, a busca vetorial emergiu como um pilar fundamental. No entanto, para construir aplicações verdadeiramente robustas, a busca vetorial pura nem sempre é suficiente. Embora excepcional em capturar o significado conceitual, ela pode falhar em identificar IDs alfanuméricos específicos ou códigos de SKU de produtos. É aqui que entra a busca híbrida: a poderosa combinação de busca vetorial semântica com a tradicional busca textual por palavras-chave exatas.
O Padrão BM25 Agora Integrado aos Bancos de Dados
No campo da busca, o BM25 (Best Matching 25) é um algoritmo amplamente reconhecido por estimar a relevância de um documento para uma consulta específica. Anteriormente, a implementação do BM25 em conjunto com AlloyDB ou Cloud SQL exigia a integração de um backend de busca textual separado. Essa abordagem trazia consigo desafios como a criação de silos de dados, atrasos na sincronização e complexidade operacional. Agora, essa barreira é eliminada com a introdução do índice BM25 nativo em pré-visualização (Private Preview) no AlloyDB e Cloud SQL para PostgreSQL 17+, impulsionado pela extensão de código aberto pg_textsearch, desenvolvida pela TigerData.
Benefícios da Busca Híbrida Unificada
Com um backend de busca híbrida unificado, empresas não precisam mais provisionar, gerenciar ou pagar por sistemas separados para obter funcionalidades avançadas de recuperação textual. Tudo acontece diretamente no banco de dados, onde os dados operacionais já residem, proporcionando:
- Ranking de Palavras-Chave Padrão da Indústria: Utilizando a extensão
pg_textsearchda TigerData, o BM25 oferece pontuação rápida e otimizada em C diretamente nas tabelas PostgreSQL. - Simplicidade e Consistência Total: Elimine a duplicação de dados, os pipelines de ETL e os atrasos de sincronização inerentes à manutenção de múltiplos backends para busca vetorial e textual.
- Busca Semântica Aprimorada (Exclusivo AlloyDB): Obtenha buscas vetoriais até 6x e 10x mais rápidas (em comparação com o PostgreSQL padrão) com os tipos de índice ScaNN e HNSW.
Por que o pg_textsearch?
Para quem já utilizou o ts_rank nativo do PostgreSQL em larga escala, as limitações são conhecidas. A qualidade do ranking degrada com o crescimento do corpus, e a falta de suporte para a frequência inversa de documentos (IDF) faz com que palavras comuns tenham o mesmo peso que as raras. Além disso, a ausência de saturação de frequência de termos pode levar um documento com 50 menções a uma palavra a superar outro com apenas uma. O BM25, por outro lado, é o padrão ouro em recuperação de informação, incorporando IDF, saturação de frequência de termos e normalização do comprimento do documento.
Exemplo de Busca Textual Completa
Para iniciar com a busca textual BM25 no AlloyDB e Cloud SQL, considere uma tabela de exemplo, cymbal_products, contendo um identificador único (uniq_id), o nome do produto (product_name), uma descrição (product_description) e um embedding gerado (product_embedding). Esta tabela armazena informações sobre diversos produtos de varejo, como plantas internas e externas.
Criação de Índice
Para usar o BM25, habilite a extensão pg_textsearch:
-- Instala a extensão pg_textsearch
CREATE EXTENSION pg_textsearch;
Em seguida, crie o índice BM25 na coluna product_description da tabela cymbal_products:
-- Cria o índice nativo BM25 na coluna de conteúdo
CREATE INDEX idx_docs_bm25
ON cymbal_products
USING bm25 (product_description)
WITH (text_config='english');
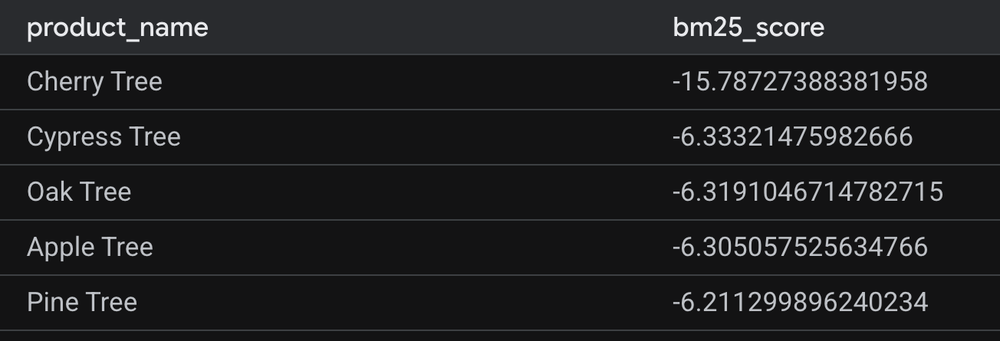
Uma consulta de busca textual BM25 pode ser executada usando o operador especial <@>. Abaixo, um exemplo de busca por 'cherry tree':
-- Consulta de busca textual completa
SELECT product_name, product_description <@> 'cherry tree' AS bm25_score
FROM cymbal_products
ORDER BY bm25_score
LIMIT 5;
A saída mostra que uma pontuação mais negativa indica uma correspondência de relevância mais forte.
Exemplo de Busca Híbrida no AlloyDB
A configuração de um sistema de busca híbrida no AlloyDB é simplificada. É possível criar índices vetoriais e de palavras-chave na mesma tabela e mesclar os resultados de forma transparente utilizando a função definida pelo usuário (UDF) de busca híbrida.
Criação de Índice Vetorial
Veja como criar um índice de busca vetorial ScaNN:
-- Instala a extensão vetorial
CREATE EXTENSION vector;

-- Instala a extensão scann
CREATE EXTENSION IF NOT EXISTS alloydb_scann;

-- Cria o índice de busca vetorial scann
CREATE INDEX cymbal_products_embeddings_scann ON cymbal_products USING scann(product_embedding cosine);
Esta nova funcionalidade representa um avanço significativo para desenvolvedores que buscam criar experiências de busca mais inteligentes e precisas, unindo o melhor dos mundos semântico e textual diretamente em seus bancos de dados PostgreSQL gerenciados.


chat_bubble Comentários (0)
Nenhum comentário ainda. Seja o primeiro a comentar!
Deixe seu comentário