
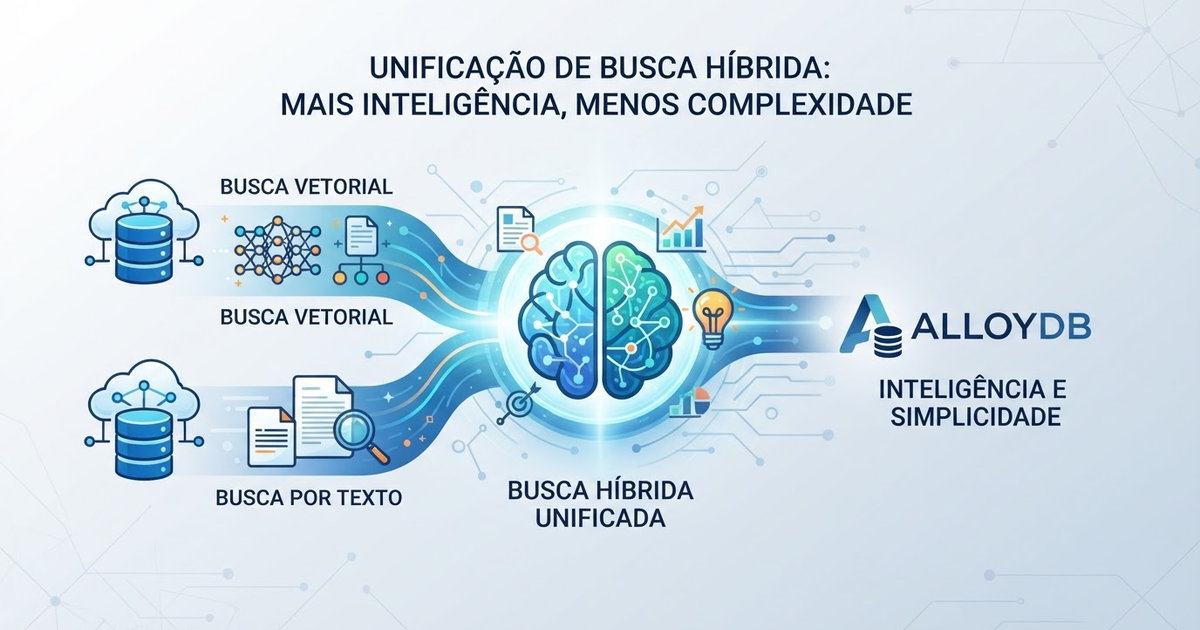
AlloyDB para PostgreSQL: A Revolução da Busca Híbrida para Aplicações de IA
Em um cenário de rápida evolução da Inteligência Artificial (IA) e das aplicações de Retrieval Augmented Generation (RAG), a relevância na busca de informações tornou-se um pilar fundamental. Tradicionalmente, alcançar essa relevância exige a combinação de duas técnicas poderosas: a busca vetorial, para capturar o contexto semântico, e a busca por texto completo (FTS), para garantir a precisão das palavras-chave. O AlloyDB for PostgreSQL, plataforma robusta e escalável, oferece ambas as capacidades, mas sua gestão integrada representava um desafio operacional significativo.
O principal obstáculo não residia na execução individual das buscas, mas na complexa fusão dos resultados. Unir as pontuações de distância da consulta vetorial com os scores de relevância da busca por texto exigia consultas SQL elaboradas ou código customizado na camada de aplicação. Essa necessidade frequentemente resultava na manutenção de sistemas paralelos para a fusão, normalização de scores e reclassificação (re-ranking), aumentando a complexidade e o custo de manutenção.
Desvendando a Complexidade com o AlloyDB AI
O AlloyDB AI surge como uma solução transformadora, eliminando essa complexidade através de sua funcionalidade de busca híbrida unificada. As atualizações recentes introduzem recursos que simplificam drasticamente o fluxo de trabalho, permitindo:
- Busca Híbrida Simplificada: Consolide consultas SQL complexas e fluxos de trabalho de aplicação em uma única função SQL de alta performance. O poder da Reciprocal Rank Fusion (RRF) permite a fusão de resultados de diversas fontes de forma elegante e eficiente.
- Otimização da Busca por Texto Completo (FTS): Utilize a nova extensão RUM (Relational Updateable Materialized Views) para obter ranqueamento de relevância de baixa latência e correspondência de frases eficiente, armazenando as posições das palavras diretamente no índice.
- Ranqueamento Padrão da Indústria: Beneficie-se do novo índice BM25, nativamente suportado, que oferece pontuação superior baseada em palavras-chave, diretamente na caixa.
- Versatilidade Expandida: Execute consultas em clusters externos especializados, como Elasticsearch, OpenSearch e Solr, através do novo Foreign Data Wrapper (FDW) de busca externa, tudo isso sem sair do ambiente AlloyDB.

O Problema do Fluxo de Trabalho Multi-etapas
Antes da solução nativa do AlloyDB AI, alcançar uma busca híbrida robusta era um desafio considerável. Desenvolvedores que tentavam manter essa lógica dentro do banco de dados, utilizando SQL padrão, enfrentavam um processo de orquestração multi-etapas. Essa abordagem era difícil de gerenciar e manter para duas fontes e tornava-se impraticável em escala com a adição de mais fontes. O fluxo típico envolvia:
- Execução da Busca Vetorial: Uma consulta é realizada em uma coluna vetorial ou índice (como o índice ScaNN no AlloyDB) para obter os principais resultados e seus scores vetoriais.
- Execução da Consulta FTS: Uma consulta de texto completo, utilizando índices como o GIN, é executada para encontrar os principais resultados baseados em palavras-chave.
- Normalização de Scores (Etapa Frágil): Lógica complexa em SQL ou código de aplicação é necessária para mapear ambos os conjuntos de resultados para uma escala comum. Essa lógica é propensa a falhas com mudanças na distribuição dos dados.
- Junção e Reclassificação Inter-serviços: A memória da aplicação é utilizada para realizar um `FULL OUTER JOIN` nos IDs dos documentos, aplicar uma soma ponderada dos scores normalizados e, finalmente, ordenar os resultados combinados, especialmente se a busca FTS e a vetorial ocorriam em sistemas distintos.
Essa arquitetura descentralizada resultava em lógica de pontuação frágil, latência aumentada, alta carga operacional e uma dependência de expertise em aplicação para manter a qualidade da busca.
Simplificando Arquiteturas de Busca Híbrida com AlloyDB
A chave para simplificar este cenário reside na adoção da Reciprocal Rank Fusion (RRF). Por ser intrinsecamente baseada em ranqueamento, a RRF contorna a etapa crítica e frágil da normalização de scores. O processo com RRF consiste em:
1. Uma Fonte Única de Verdade
Em vez de um processo de busca e junção multi-etapas, o AlloyDB permite a chamada de uma única função SQL. Os componentes da busca são fornecidos como um array JSON declarativo, simplificando a orquestração:
SELECT id, score
FROM ai.hybrid_search(
    search_inputs => ARRAY[
        -- Componente Vetorial (Semântico) com geração dinâmica de embedding
        $json${
            "data_type": "vector",
            "limit": 10,
            "table_name": "documents",
            "key_column": "doc_id",
            "vec_column": "embedding",
            "distance_operator": "<=>",
            "query_vector": "ai.embedding('text-embedding-005', 'alloydb search')::vector"
        }$json$::jsonb,

        -- Componente de Texto (Palavra-chave)
        $json${
            "data_type": "text",
            "limit": 10,
            "table_name": "documents",
            "key_column": "doc_id",
            "text_column": "content",
            "query_text_input": "alloydb search"
        }$json$::jsonb
    ]
);
(É importante notar que a API unificada ai.hybrid_search não se limita a dois componentes e suporta nativamente fontes de busca externas via FDW.)
2. Orquestração Nativa no Banco de Dados
A função hybrid_search() executa todo o fluxo de trabalho em um único plano de consulta, minimizando a sobrecarga e garantindo a consistência transacional. Isso é alcançado através de:
- Geração Dinâmica de CTEs: A função constrói SQL dinamicamente, criando Common Table Expressions (CTEs) para cada componente. Cada CTE é responsável por calcular o ranqueamento posicional (
ROW_NUMBER()) de seus resultados. - Fusão em Nível de Kernel: Todos os resultados classificados dos componentes são imediatamente combinados usando um
FULL OUTER JOINbaseado no ID do documento. - Ranqueamento com RRF: Os ranks posicionais de cada fonte são utilizados para calcular um score combinado pela fórmula RRF, sem a necessidade de normalização explícita de scores.
Ao integrar a busca vetorial, a busca por texto completo e outros tipos de busca em uma única função SQL, o AlloyDB elimina a necessidade de orquestração complexa e infraestrutura paralela. Isso resulta em:
- Arquitetura Simplificada: Menos componentes para gerenciar e manter.
- Melhor Performance: Execução otimizada dentro do banco de dados.
- Menor Custo Operacional: Redução da carga de infraestrutura e manutenção.
- Maior Relevância: Combinação eficaz de semântica e precisão de palavras-chave para aplicações de IA.
O AlloyDB está redefinindo o padrão para buscas híbridas, tornando mais acessível e eficiente para empresas que buscam alavancar o poder da IA e RAG com dados confiáveis e de alta performance.


chat_bubble Comentários (0)
Nenhum comentário ainda. Seja o primeiro a comentar!
Deixe seu comentário